캡처 개인정보 가리기
캡처의 이름·전화번호를 불투명한 영역으로 가리고 새 PNG로 저장하세요. 여러 사진에 같은 비율 위치를 적용하고 개별 확인 후 ZIP으로 받을 수 있습니다. 사진은 서버에 보내지 않습니다.
개인정보 가리기캡처 편집전화번호 가리기이미지 일괄 처리사진 보안
사진·캡처·스캔 PDF의 한글과 영문을 설치 없이 인식하고, 원본과 비교해 수정·복사·TXT 저장하세요.
캡처 안의 글자를 다시 입력하지 않고 복사하되, 숫자 오류는 놓치지 않아야 합니다.
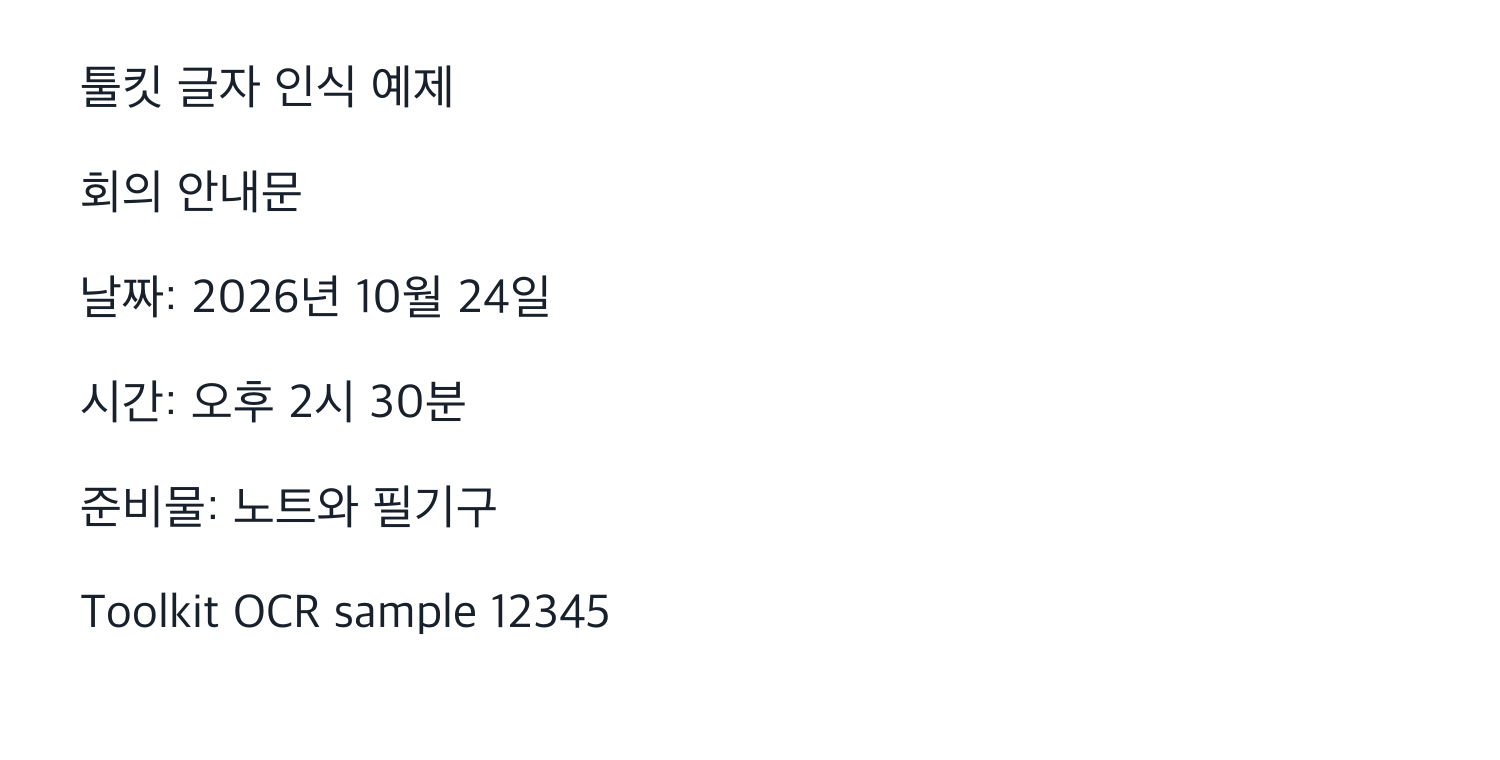
같은 PNG로 한글+영문 OCR을 실행하고 검수용 원문과 나란히 대조하세요.툴킷이 만든 가상 예제입니다. 실제 고객·회사의 자료가 아닙니다. 파일과 예제 설명 갱신:
| 확인 항목 | 원본에 적힌 값 | 검수할 부분 |
|---|---|---|
| 날짜 | 2026년 10월 24일 | 연도와 일자가 다른 숫자로 인식되지 않았는지 |
| 시간 | 오후 2시 30분 | 숫자·공백·오후 표시 |
| 준비물 | 노트와 필기구 | 한글 누락과 비슷한 글자 |
| 영문·숫자 | Toolkit OCR sample 12345 | 영문 철자와 숫자 순서 |
2026년 10월 24일 브라우저 점검에서는 ‘자동 — 일반 문서’가 상단 제목 두 줄을 누락했습니다. ‘한 덩어리 — 문단’으로 바꾼 뒤에는 여섯 줄의 글자를 모두 읽었고 빈 줄이 추가됐습니다. 아래 인식 결과 TXT는 이 점검에서 실제로 받은 파일이며, 검수용 원문 TXT는 이미지 제작에 쓴 텍스트입니다. 다른 이미지·환경에서 같은 정확도를 보장하지 않으므로 제목과 숫자도 대조하세요.
필기체·기울어진 사진·작은 글씨는 오류가 늘 수 있습니다. 이미 글자를 선택할 수 있는 PDF는 PDF 글자 추출 도구가 적합합니다. OCR 결과는 원본과 같은 서식의 표나 문서를 재현하지 않습니다.
결과가 다르면 사용한 설정과 오류 메시지를 확인해주세요. 개인정보를 제외하고 오류 제보하기 →
이 도구로 직접 처리하기 ↑인쇄체 중심 OCR이며 손글씨·흐린 사진·복잡한 표는 정확도가 낮을 수 있습니다. 10MB, 이미지 2,500만 픽셀, 암호·양식·전자서명이 없는 PDF 100페이지 중 한 번에 10페이지까지 지원합니다. 인식용 이미지는 800만 픽셀·긴 변 6,000px 이하로 조절합니다. PDF는 약 200dpi를 목표로 렌더링하며 큰 페이지는 낮아집니다. 이미지 애니메이션은 첫 프레임만 처리합니다. 원본을 수정하거나 검색 가능한 PDF·표 서식을 만들지 않습니다. 결과는 페이지당 100,000자까지, 서버 전송 없이 브라우저 안에서 처리하며 탭을 닫으면 사라집니다.